503、robots.txt 与方括号 URL:SEO 抓取问题怎么排查
简答:503 适合短时维护或过载,robots.txt 只控制符合规则的抓取,方括号原始写法与编码写法应统一。排查时先看状态码,再查 robots.txt、规范链接、站点地图和服务器日志。
定义:本文所说的 SEO 抓取问题,是指搜索爬虫访问网站时出现的临时不可用、抓取权限、URL 规范化或图片格式兼容问题。
先看这张表:不同症状对应什么处理
本文编译整理自原文出处,并用公开的抓取文档补充可执行步骤。先不要同时修改多个配置,先根据返回码和 URL 形式确定问题层级。
| 症状 | 优先判断 | 建议处理 |
|---|---|---|
| 维护期间页面大量返回 200 或 404 | 临时停机信号不明确 | 让 Web 服务器、CDN 或临时基础设施返回 503,恢复后撤销 |
| 503 持续数天 | 临时错误可能被当成长期不可用 | 尽快恢复正常响应,并持续观察抓取与索引变化 |
| robots.txt 修改后仍被抓取 | 规则可能不适用于当前主机、协议或端口 | 检查文件位置、HTTP 响应、User-agent 和请求日志 |
| 同一内容出现 /items/[a] 与 /items/%5Ba%5D | 两种 URL 形式可能被分别处理 | 选择一种形式,统一链接、canonical、站点地图和结构化数据 |
| 图片页面正常但图片搜索没有展示 | 图片格式可能不在支持范围 | 在 img 的 src 中保留 JPEG、WebP、AVIF 等兼容格式,现代格式作为可选 source |
官方抓取排查文档建议结合抓取统计、具体 URL 检查和服务器日志判断可用性问题,而不是只根据浏览器能否打开页面下结论。可参考抓取错误排查文档。
503 临时停机:返回码、部署位置和恢复顺序
503 表示服务暂时不可用,适合短时间维护、补丁升级或服务器过载。它与 404 的“资源不存在”、500 的“服务器内部错误”以及返回 200 的普通错误页含义不同。临时停机时,核心目标是让爬虫知道问题具有临时性,而不是把维护页伪装成正常页面。
最短实施流程
- 先确认停机范围。如果只是 PHP 或应用层无法工作,优先考虑由应用之外的 Web 服务器、CDN 规则、临时服务器或其他仍能响应请求的基础设施返回 503。
- 保留 robots.txt 可访问。不要因为维护页配置错误,让 robots.txt 也返回超时或错误状态。robots.txt 本身应使用正常的 HTTP 响应,并确认它位于当前主机的顶级目录。
- 检查实际响应。使用命令查看状态码和响应头:
curl -I https://example.com/。将示例域名替换为自己的站点,不要只看页面上的“维护中”文字。 - 恢复后立即撤销 503。恢复正常页面后,再用抓取统计、URL 检查和服务器日志确认爬虫能够重新访问。
官方文档说明,503 或 429 只能作为临时措施使用。持续返回不可用状态超过约两天,可能导致抓取速度下降,甚至使相关 URL 被移出索引,因此不能把 503 当成长期屏蔽方案。具体限制和站点状态仍需结合实际日志判断,参考官方抓取错误处理说明。
常见错误对照
- 返回 200 的维护页:爬虫可能把它当作正常页面,页面原内容与维护状态的信号不清晰。
- 返回 404:更接近“资源不存在”,不适合作为短时维护的统一状态。
- 返回 500:表示服务器内部错误,不能准确表达“服务会很快恢复”。
- 只在 PHP 中输出 503:如果 PHP 本身已经停止,代码可能根本没有执行,需把临时响应放在仍可用的基础设施上。
robots.txt 能控制什么:抓取权限不等于内容后续使用
robots.txt 是抓取访问规则,不是内容使用协议。它主要告诉遵守该规则的自动抓取器哪些路径可以访问,不能保证所有访问者都会执行,也不能单独决定已经获取内容之后的所有使用方式。
官方规范说明,robots.txt 必须放在站点顶级目录,规则只对对应的主机、协议和端口生效。例如,https://example.com/robots.txt 不会自动覆盖其他子域名、不同协议或其他端口。可参阅robots.txt 规范说明。
核验 robots.txt 的四个条件
- 位置:确认访问地址是当前站点根路径下的
/robots.txt,而不是某个目录里的同名文件。 - 状态码:用
curl -I https://example.com/robots.txt检查是否能够稳定返回。 - 规则对象:确认 User-agent 是否写对,Disallow 的路径是否与实际 URL 路径一致。
- 适用范围:分别检查 HTTP、HTTPS、主域名、带 www 子域名和其他端口,不要假设一份文件覆盖所有入口。
如果目标是控制不同 AI 抓取器的访问,应先区分“是否允许抓取”和“抓取之后如何使用”两个问题。不要把 robots.txt 当作索引删除、内容撤回或训练用途控制的万能开关;对于具体平台,应以其公开的抓取器说明为准。
方括号 URL:原始写法和 %5B、%5D 为什么要统一
例如下面两种地址看起来指向同一资源,但在抓取和 URL 规范化处理中可能被视为不同 URL:
https://example.com/items/[a]https://example.com/items/%5Ba%5D
公开说明指出,原始方括号与百分号编码形式可能被分别抓取。如果两种地址都返回相同内容,系统还需要额外进行重复内容处理并选择一个版本。最稳妥的做法是为同一站点选择一种写法,并在所有入口保持一致。
统一 URL 的操作清单
- 确定规范形式:新站或新功能优先采用符合 URL 标准的编码形式;已有站点不要在没有映射和验证的情况下批量改写。
- 统一站内链接:导航、正文、分页、图片链接和 JavaScript 生成的地址都使用同一种形式。
- 统一 canonical:规范链接指向选定版本,不要一个页面指向原始方括号,另一个页面指向编码形式。
- 统一站点地图:站点地图中的 URL 与 canonical、内部链接保持一致。
- 统一结构化数据:JSON-LD 中的 url、image、主实体地址也要检查编码形式。
- 检查服务器行为:分别请求两种 URL,记录状态码、Location、内容哈希和 canonical,避免改写后形成循环或多跳。
如果历史上已经同时公开两种形式,可先选择主版本,再通过服务器端规范化或明确的重定向逐步收敛。不要只修改 canonical,却继续在内部链接和站点地图中输出另一种形式。
JPEG XL 图片:保留回退格式比只换源格式更稳妥
原文提到,JPEG XL 文件当前不适合作为图片搜索和发现类预览的唯一依赖格式。对需要兼顾浏览器展示、搜索抓取和社交分享的页面,应在 img 的 src 中保留兼容格式,再通过 picture 为支持新格式的浏览器提供可选资源。
可参考下面的通用写法:
<picture>
  <source type="image/jxl" srcset="/images/demo.jxl">
  <source type="image/avif" srcset="/images/demo.avif">
  <img src="/images/demo.webp" alt="示例图片">
</picture>
这里的关键不是强制使用某一种图片格式,而是确保 img src、页面预览图、结构化数据中的图片地址仍指向站点实际希望被识别的兼容格式。上线后应分别检查 HTML 源码、图片响应头、页面预览和服务器日志。
上线前的统一排查顺序
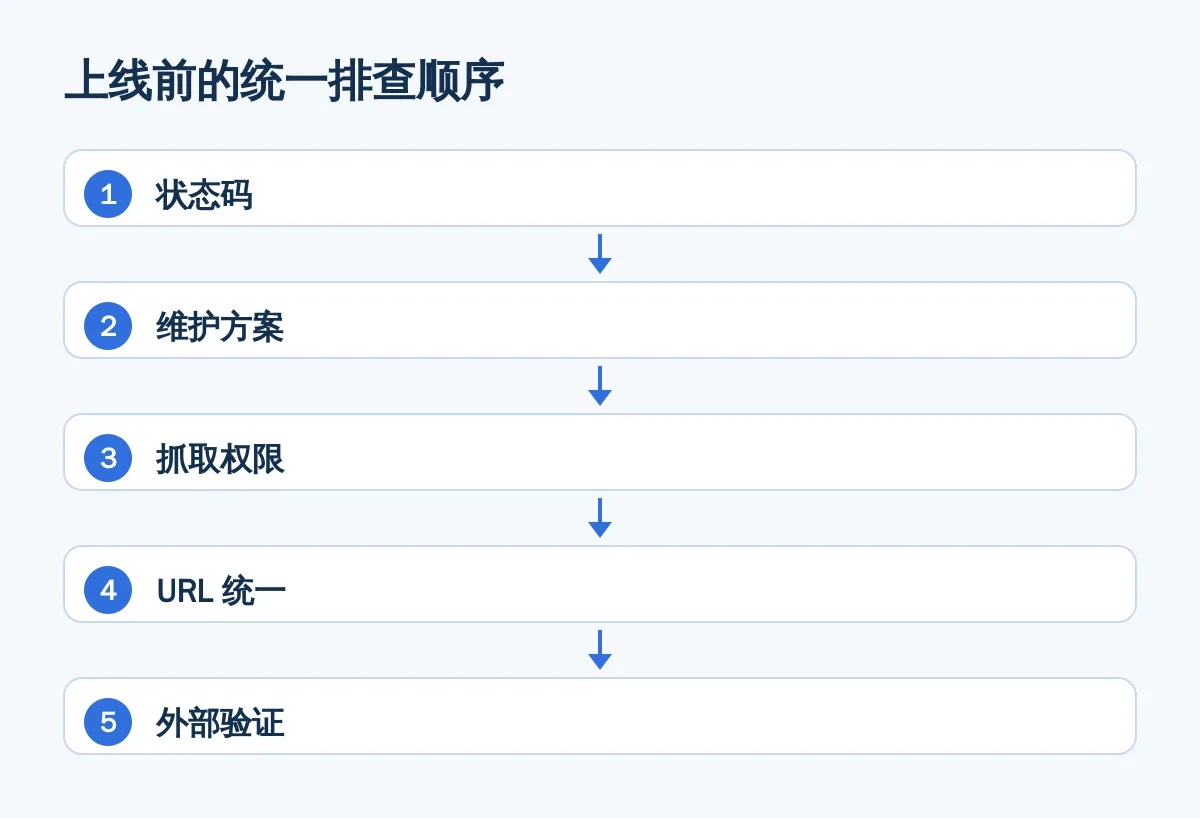
- 状态码:首页、重点内容页、robots.txt 和站点地图分别请求,记录是否出现 503、429、500、404、重定向链或超时。
- 维护方案:确认 503 由仍可用的 Web 服务器、CDN 或临时基础设施提供,而不是依赖已经停止的应用。
- 抓取权限:检查 robots.txt 的位置、状态码、User-agent、Disallow 路径以及主机和协议范围。
- URL 统一:搜索原始方括号、编码方括号、大小写差异和尾部斜杠差异,比较 canonical、站点地图和内部链接。
- 图片兼容:确认
img src和预览图不是只指向当前抓取链路未验证的格式。 - 外部验证:使用抓取统计、具体 URL 检查和服务器日志交叉验证,不要只凭单次浏览器访问判断。
修改配置时建议一次只改变一个变量,并保存修改前后的响应头、HTML、robots.txt 和日志片段。这样才能判断问题究竟来自服务器可用性、抓取规则、URL 规范化还是资源格式。
常见问题
网站维护时一定要返回 503 吗?
如果是短时间维护或临时过载,503 比 200、404 更能表达“暂时不可用”。但 503 不应长期持续,恢复后要撤销,并通过抓取统计、URL 检查和日志确认访问恢复。
robots.txt 能阻止已经抓取的内容被继续使用吗?
不能把它理解为万能控制开关。robots.txt 主要表达符合规则的抓取访问偏好,不能单独决定内容在已经被获取之后的所有使用方式。具体用途应查看相关抓取器的公开规则。
原始方括号和 %5B、%5D 可以混用吗?
不建议混用。两种形式可能被当作不同 URL,混用会增加重复处理和规范版本选择的不确定性。应选定一种形式,并统一内部链接、canonical、站点地图和结构化数据。
503 应该由 PHP 程序返回吗?
不一定。如果 PHP 正在维护或已经停止,程序可能无法输出 503。更稳妥的方式是由仍可用的 Web 服务器、CDN 或临时基础设施返回,并确保 robots.txt 仍能访问。
JPEG XL 页面图片如何兼容搜索抓取?
不要只把 JPEG XL 作为 img 的唯一 src。可以使用 picture 提供可选 source,同时在 img src 中保留已经验证的兼容格式,并同步检查页面预览图和结构化数据中的图片地址。