统一 AI 训练退出信号怎么配置:网站管理员操作指南
简答:统一 AI 训练退出信号是写入 robots.txt 的用途标记,用于表达是否允许生成式模型训练;网站管理员应分别检查训练、回答引用、传统抓取和搜索收录,并确认各平台实施时间。
定义:统一 AI 训练退出信号,是以 <code>__usage_ai-training</code> 作为 robots.txt 的 User-Agent 标记,用 Allow 或 Disallow 表达网站或路径是否允许被用于生成式 AI 模型训练。
先看结论:统一信号目前是什么状态
本文编译整理自原文出处,并结合相关平台的官方说明重新组织。到 2026 年 11 月 8 日,__usage_ai-training 仍来自 IETF Internet-Draft,不是正式发布的互联网标准;不同平台已经公布支持计划,但实际生效时间和冲突处理方式并不完全相同。IETF 草案
| 事项 | 当前可确认结论 | 网站管理员动作 |
|---|---|---|
| 统一训练信号 | __usage_ai-training 使用普通 robots.txt 规则表达训练偏好 | 先在测试环境生成并检查,不要把草案当成永久标准 |
| AI 训练 | 指用内容修改生成式模型的已学习参数 | 通过全站或路径级 Allow/Disallow 表达偏好 |
| AI 回答引用 | 指内容被作为生成回答的输入,不等于模型训练 | 按平台要求检查页面级 meta 标签或 HTTP 响应头 |
| 传统搜索收录 | 与训练和回答引用是不同用途 | 继续单独检查抓取、索引、Canonical 和 Sitemap |
| 标准状态 | 当前是个人提交的 Internet-Draft,没有正式标准地位 | 记录核验日期,后续关注语法和实施变化 |
官方说明明确表示,统一信号不会改变传统 robots.txt 的抓取控制逻辑,也不等于禁止搜索引擎抓取或收录。相关官方说明 草案定义
robots.txt 怎么写:全站退出、部分路径开放和默认状态
当前草案没有新增 robots.txt 指令,而是使用一个用途标记作为 User-Agent。如果网站希望表达全站不允许用于 AI 训练,可以先采用下面的写法:
User-Agent: __usage_ai-training
Disallow: /
如果只限制某个路径,可以改为:
User-Agent: __usage_ai-training
Disallow: /private-content/
草案示例还展示了“全站禁止、指定路径允许”的最长匹配逻辑:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
这里的 Allow 和 Disallow 只是对“是否允许该用途”表达偏好,不是新的抓取命令。IETF 草案还特别说明,User-Agent: * 不会自动匹配 __usage_ai-training;如果 robots.txt 中没有这个用途标记,则表示没有表达统一训练偏好。IETF 草案中的规则说明
- 想退出全站训练:使用
User-Agent: __usage_ai-training加Disallow: /。 - 只退出部分目录:将
Disallow指向具体路径。 - 只开放例外目录:结合全站
Disallow与更具体的Allow。 - 只想控制抓取:继续为具体爬虫单独写规则,不要把统一训练标记当成抓取封锁。
上线前建议保存一份变更记录,至少包含文件版本、修改日期、适用路径、预期用途和验证结果。由于该机制仍处于草案及分阶段实施状态,生产站不应只依赖一条规则判断所有平台的最终行为。
AI 训练、回答引用和传统搜索收录有什么区别
网站管理员最容易混淆的是“模型训练”和“回答引用”。训练通常指内容被用于修改模型参数;回答引用或 grounding 则是模型生成回答时,把网页内容作为输入或依据。传统搜索收录则涉及抓取、解析、索引和结果呈现,三者不能互相替代。
| 控制对象 | 解决的问题 | 常见配置位置 | 是否等于禁止搜索收录 |
|---|---|---|---|
| AI 训练 | 是否允许内容用于修改生成式模型参数 | robots.txt 或平台支持的页面级设置 | 否 |
| AI 回答引用 | 是否允许网页帮助生成回答 | 页面 meta 标签或 HTTP 头 | 否 |
| 传统抓取 | 爬虫是否访问网页 | 具体爬虫的 robots.txt 规则 | 可能影响发现和收录,但不是训练信号本身 |
| 搜索收录 | 网页是否进入搜索索引并展示 | 抓取、索引、Canonical、质量等信号 | 需要单独排查 |
一份平台官方说明把 AI Training 与 AI Grounding 明确拆开:训练偏好可以在 robots.txt 或页面级表达,而回答引用偏好是页面级设置;没有设置时,相关用途可能默认为允许。平台官方迁移说明
因此,假如网站只想禁止训练但仍希望内容有机会出现在 AI 生成回答的来源中,就不能简单地把所有爬虫全部禁止;应分别评估训练、回答引用和传统搜索的目标,再逐项配置。
2026 年 11 月后的网站检查顺序
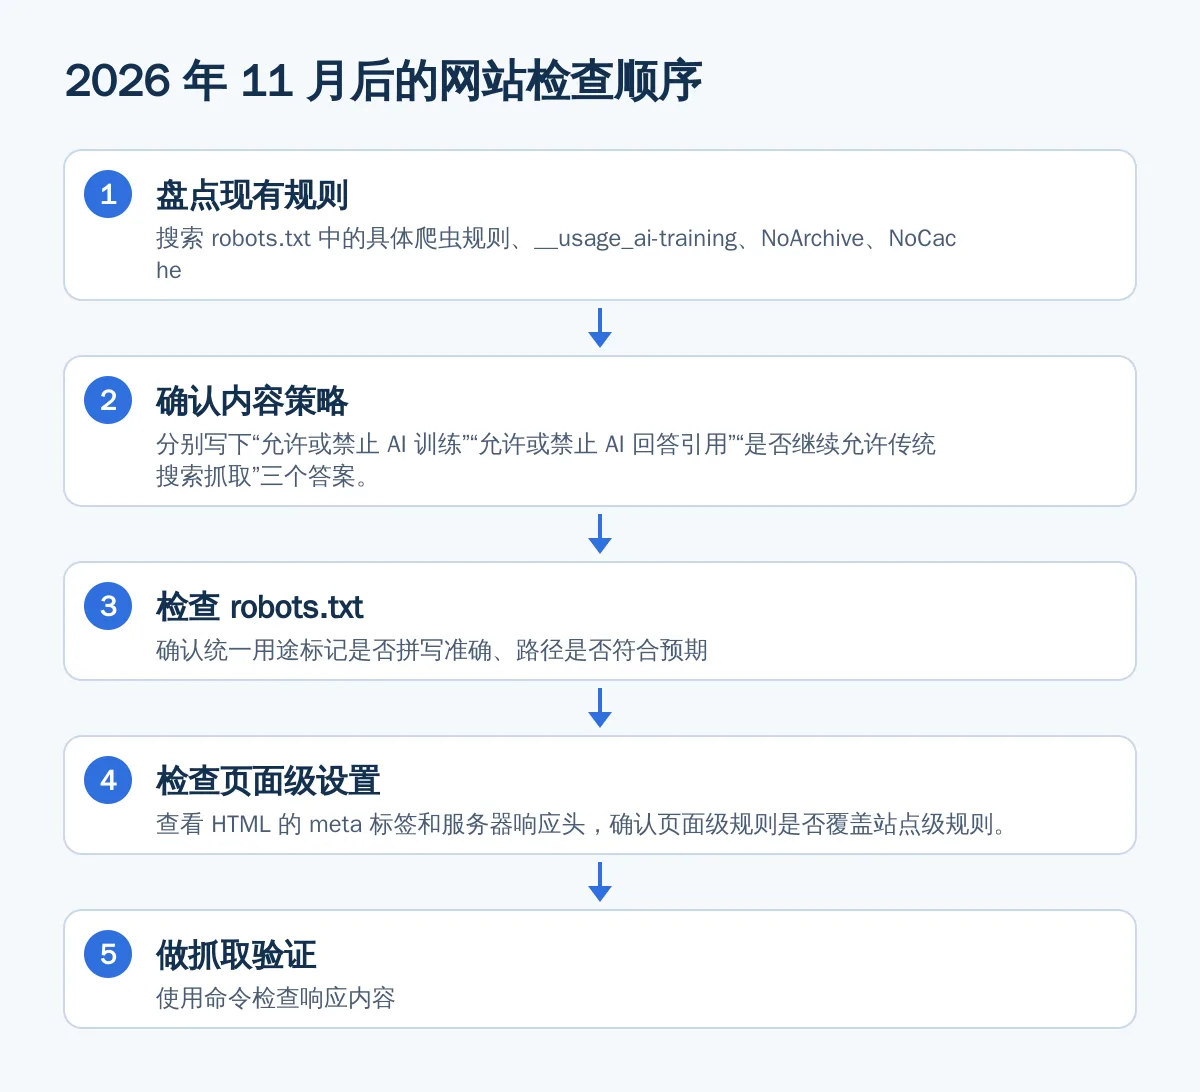
- 盘点现有规则:搜索 robots.txt 中的具体爬虫规则、
__usage_ai-training、NoArchive、NoCache,并记录它们分别想控制什么。 - 确认内容策略:分别写下“允许或禁止 AI 训练”“允许或禁止 AI 回答引用”“是否继续允许传统搜索抓取”三个答案。
- 检查 robots.txt:确认统一用途标记是否拼写准确、路径是否符合预期,并确认没有把
User-Agent: *误认为可以匹配用途标记。 - 检查页面级设置:查看 HTML 的 meta 标签和服务器响应头,确认页面级规则是否覆盖站点级规则。
- 检查旧规则迁移:如果仍使用
NoArchive或NoCache,不要假设它们会永久代表新的训练或回答引用偏好。 - 做抓取验证:使用命令检查响应内容,例如
curl -I https://example.com/page,确认 HTTP 头是否真实返回;再直接访问 robots.txt 检查状态码和文本。 - 留存验收记录:保存修改前后文件、页面 URL、响应头、检查时间、预期结果和实际结果,后续按平台重新抓取情况复核。
页面级规则能否立即生效,取决于平台何时重新抓取页面。官方说明也强调,发布配置不等于平台已经发现配置;重新抓取前,旧状态可能仍被使用。官方实施限制说明
平台差异和已公布时间点
| 平台或标准参与方 | 已公开信息 | 仍需核实的部分 |
|---|---|---|
| 搜索服务提供方 A | 计划在 2027 年支持统一 AI 训练控制;如果未单独指定其专属控制,计划把统一退出理解为相应 AI 扩展爬虫被禁止 | 正式上线日期、最终冲突优先级和实施细节 |
| 搜索服务提供方 B | 2027 年 2 月 1 日起,随着抓取开始识别新训练和回答引用偏好;2027 年 3 月 1 日后,旧的 NoArchive 与 NoCache 不再作为相关偏好 | 具体页面何时重新抓取,取决于实际抓取周期 |
| 生成式 AI 服务提供方 | 表示将在未来数月支持共同信号,现有爬虫控制继续适用 | 正式生效日期,以及共同信号与专属爬虫规则冲突时的处理方式 |
| IETF 草案 | 2026 年 10 月 30 日更新,当前版本为个人 Internet-Draft,预计 2027 年 5 月 3 日到期 | 未来是否进入正式标准、语法和词汇是否变化 |
如果网站使用旧的 NoArchive 或 NoCache,应重点关注 2026 年 12 月 15 日、2027 年 2 月 1 日和 2027 年 3 月 1 日这几个线路。对于仍依赖旧标签限制回答引用的网站,官方迁移说明要求在页面发布新的回答引用偏好,并在规定时间前完成临时过渡设置。迁移时间表与配置说明
三种网站配置思路:新闻内容、商业页面和部分路径开放
新闻或资料站:如果目标是继续获得传统搜索曝光,同时只限制模型训练,可先单独评估统一训练信号,不要直接封锁所有爬虫;回答引用是否开放,应另行决定。
商业页面:如果更关心生成回答中的来源展示,应把 AI 训练和回答引用分开评估。禁止回答引用可能降低相关 AI 体验中的展示机会,但官方说明没有承诺允许后一定获得收录、流量或收益。官方限制说明
部分路径开放:可以使用全站 Disallow,再用更具体的 Allow 开放资料页、公开文档或媒体包目录;上线后必须逐条检查最长匹配路径是否符合预期。
以上是配置方法和基于官方规则的操作推断,不代表所有平台在当前日期已经完成支持。对未公布正式日期、冲突优先级或完整兼容矩阵的部分,应标记为“需核实”,不要写成确定行为。
常见排查错误
- 把统一训练信号当成禁止抓取:错误。它表达的是内容用途偏好,具体抓取仍由对应爬虫的规则控制。
- 以为通配符会自动匹配:当前草案明确说明,
User-Agent: *不会自动匹配__usage_ai-training。 - 只改 robots.txt,不检查页面头:错误。回答引用和单页训练控制可能需要 meta 标签或 HTTP 响应头。
- 只看文件是否更新,不看平台是否重新抓取:错误。发布配置与平台发现配置之间存在时间差。
- 把 Internet-Draft 当成正式标准:错误。当前文档没有正式 IETF 标准地位,未来语法和实施范围可能变化。
常见问题
统一 AI 训练退出信号已经正式生效了吗?
还不能这样概括。当前 <code>__usage_ai-training</code> 来自个人提交的 IETF Internet-Draft,官方页面明确写明它没有正式 IETF 标准地位;不同平台虽已公布支持计划,但正式生效时间仍需按各平台公告核验。
robots.txt 写了 Disallow: /,会不会影响传统搜索收录?
仅针对 <code>User-Agent: __usage_ai-training</code> 的规则,表达的是 AI 训练用途偏好,不等于禁止具体搜索爬虫抓取。传统收录仍要单独检查具体爬虫规则、页面可访问性、索引指令和 Sitemap。
AI 训练和 AI 回答引用有什么区别?
AI 训练是用内容修改生成式模型参数;AI 回答引用是生成回答时把网页内容作为输入或依据。两者用途不同,允许一个并不自动允许另一个,页面管理员应分别配置和验收。
网站还在使用 NoArchive 或 NoCache,应该怎么办?
先确认这些旧标签分别用于训练还是回答引用,再按照平台公布的迁移要求补充新设置。已公布的关键线路包括 2026 年 12 月 15 日、2027 年 2 月 1 日和 2027 年 3 月 1 日;是否需要临时过渡设置取决于网站在相应日期的现有配置。
共同信号和专属爬虫规则冲突时哪个优先?
不能一概而论。部分平台已说明自己的解释方式,但另一些平台尚未公布共同信号与专属爬虫规则冲突时的完整处理逻辑。遇到冲突时,应以对应平台最新官方文档为准,并在 robots.txt、页面头和抓取日志中分别记录。
相关阅读
参考资料
- 原文出处:Google、Microsoft 与 OpenAI 计划支持统一 AI 训练退出信号
- 搜索服务官方说明:Supporting a shared AI training control for websites
- 搜索服务官方说明:Your content, your choice: clearer preferences for training and grounding
- 生成式 AI 服务官方说明:Making it easier for websites to express AI training preferences
- IETF Internet-Draft:Machine-Readable Training Preference Signal